はじめに
以前、「映画ソムリエ」という名前の映画おすすめアプリを開発しているとブログに書いた。
しかし、課題となったのは、その精度だった。
お勧めする映画が本当にその人が好みそうな映画なのか。
実際に使ってみた感想としては、「微妙」だった。
そこで、着目したのがシネマッチアルゴリズムだ。
「CineMatch(シネマッチ)」はNetflixが2000年に手掛けたレコメンドエンジンだ。
今回はそんなNetflixのレコメンドエンジンについて深堀し、映画おすすめアプリに組み込めるところがないかを考察してみる。
Netflix Prize
今回はNetflixの以下のTech Blogからレコメンドエンジンについて記載していく。


2006年、Netflixは「うちの映画レコメンドの精度を10%上げてくれたら1億円あげます」というコンペを開催した。
このレコメンドというのが既存であったCineMatchである。
そして、このコンペの名前が「Netflix Prize」である。
Netflix Prizeのルールは以下のとおりである。
- ある会員がある映画に何点(1〜5の星)をつけるか、当ててもらう
- 「当てられたかどうか」は RMSE(予測と実際のズレの大きさ) という数字で測る。ズレが小さいほど良い
- 目標: 元のズレ(0.9525)を 0.8572 以下まで縮める
つまり「星評価予測クイズ」。この時点ではまだ「レコメンド=星予測ゲーム」だと考えられていた。
1年目に「Korbellチーム」が好成績を出し、107個ものアルゴリズムを組み合わせた手法を公開した。
Netflixはその中から特に効いていた2つだけを取り出して本番に採用した。
その2つは以下の2つである。
- SVD(行列分解)
- 「この人はこういう傾向の映画が好き」という隠れた特徴を数字で表す手法
- 単体のズレ(RMSE):0.8914
- RBM(制限ボルツマンマシン)
- 隠れた好みのパターンを学習する手法
- 単体のズレ(RMSE):0.8990
この2つを混ぜるとズレは0.88まで縮んだ。
しかし、本番環境への投入は簡単ではなかった。
それは「コンペ用データは1億件だったが実際は50億件以上ある」「ユーザーが評価を追加するたびに更新できないといけない」といった課題があったためである。
その2年後、最終的に賞金1億円を獲得したのは、数百個ものモデルを組み合わせた超巨大アンサンブルだった。
ところがNetflixはこれを採用しなかった。
理由はシンプルで、「精度はわずかに上がるが、それを本番で動かす開発コストに見合わない」から。
ここがポイントで、「精度が上がる=採用すべき」ではないということ。
なぜ「星評価を当てる」だけでは不十分だったのか
NetflixはDVDレンタル(郵送)からストリーミング配信に主力を移した。
この変化がレコメンドの前提を根本から変えた。
| DVD時代 | ストリーミング時代 | |
|---|---|---|
| 視聴までの時間差 | 数日〜数週間後に届く | その場ですぐ見る |
| 選び方 | じっくり選ぶ(交換に1日以上かかるので失敗したくない) | 何本か軽く試してから決める |
| わかること | 星評価だけ | 最後まで見たか、途中でやめたかまでわかる |
ストリーミングになったことで、「どの作品を最後まで見たか」という行動データが大量に取れるようになった。
星評価は「あとで振り返って点をつける」行為だが、視聴完了率は「今まさに何を選び、どこまで見たか」という、より精度の高いデータとなる。
このため「星評価予測」から「実際に見て満足するかの予測」へと考え方がシフトしていく。
2012年時点でNetflixは47カ国2300万人以上の会員抱えていた。
その会員の視聴の75%が何らかのおすすめ経由によって視聴されていた。
Netflixの画面は「おすすめ」でできている
Netflixのホーム画面は、横並びの「棚(row)」の集まりでできている。これは1つのアルゴリズムではなく、複数の役割を持つ棚を組み合わせる設計になっている。
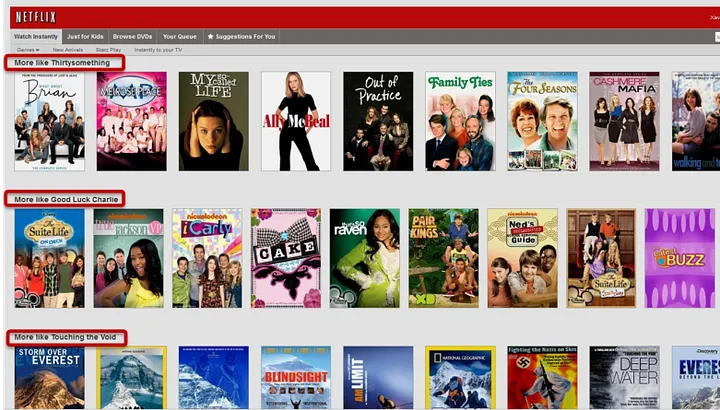
- Top10の棚: 「あなた(というより世帯全員)が一番気に入りそうな10本」
- 精度だけでなく、父・母・子どもなど異なる好みをカバーする多様性も重視される。
- ジャンルの棚: 「コメディ」のような大きな括りから、「1980年代の空想的タイムトラベル映画」のような超ニッチな括りまである
- 「どのジャンルを見せるか」「その中の何を選ぶか」「どの順で並べるか」の3段階で個人化されている。
- 類似作品の棚: 「この作品を見た人はこれも」的な、作品同士・人同士の近さをもとにしたまとまり
- なぜおすすめされたかの説明: 「ビジネスの都合ではなく、あなたの視聴履歴・評価に基づいている」ことを見せることで、ユーザーの信頼とフィードバックを引き出す
Netflixのレコメンドは「1本のアルゴリズムが1つのリストを返す」のではなく、複数の目的を持った棚を、それぞれ別ロジックで組み立てて並べるという設計思想によってできている。
「並び順」をどう決めるか
ある棚の中で映画を何本か選んだあと、どの順番で並べるかを決める必要がある。
これが「ランキング」。
まずは失敗しやすい2つの単純な方法
- 人気順だけで並べる: 「みんなが見ているものは自分も見たくなりやすい」は正しいが、これだと全員に同じ並びを返すことになり、パーソナライズの意味がなくなる。
- 予測点(この人はこの映画を何点つけそうか)だけで並べる: 個人化はできるが、「点数は高くつけそうだけどニッチすぎて見る気にならない」映画ばかりになりがち。逆に「そこまで高得点はつけなさそうだけど絶対見たい」映画が埋もれる。
だから2つを混ぜる
Netflixが最初にやった、一番シンプルな混ぜ方はこの式。
順位スコア = w1 × 人気度 + w2 × あなた向けの予測点 + 定数
w1とw2は「人気度と予測点、どっちをどれだけ重視するか」の重み。
この重みをどう決めるかというと、2つの方法がある。
- 重みの組み合わせを何パターンも作って、実際にユーザーに見せて反応を比べる(A/Bテスト)
- ⇒ ただし時間もコストもかかる
- 過去のデータから機械学習で重みを学習する(Learning to Rank と呼ばれる手法)
- 「この人は結局どっちを選んだか」という履歴を教師データにして、重みを自動で最適化する
検索エンジンや広告配信でも使われる考え方だが、レコメンドの場合は「みんなに共通の正解」ではなく、一人ひとり違う最適な並びを求める。
人気度や予測点以外にも、Netflixは色々な特徴量(監督、ジャンル、視聴時間帯など)を試しては効果を確認する、という地道な改善を繰り返している。
どんなデータを見ているか
Netflixが使っているデータの例は以下のようなものが挙げられる。
- 数十億件規模の星評価(1日に数百万件増える)
- 人気度(時間帯別・日別・週別・地域別など、いろんな粒度で計算)
- ストリーム再生ログ(いつ・どのデバイスで・どれくらい見たか)
- 「マイリストに追加した」履歴
- 作品の情報(出演者、監督、ジャンル、レビューなど)
- 「何をどこにおすすめとして出したか」と、それに対する反応(スクロール、クリック、滞在時間)
- 友達の視聴・評価(ソーシャル)
- 検索キーワード
- 外部データ(興行収入、批評家レビューなど)
ポイントは、星評価は数あるデータの中の1つに過ぎないということ。むしろ「何を見せたら、実際にどう行動したか」というログの方が重要度が高い。
「本当に良くなったか」を確かめる
Netflixがアルゴリズムを改善するときのサイクルは以下の流れとなる。
- 仮説を立てる: 「この機能を入れたら継続率が上がるはず」など
- テストを設計する: プロトタイプを作る。
- 実行する: 数千人規模のユーザーを対象に、2〜20パターンのバリエーションを同時に走らせる
- データに語らせる: 最終的に信じる指標は「視聴時間」と「継続率」
これがA/Bテスト。
いきなり本番でテストしない、2段階のチェック
本番でA/Bテストする前に、まず手元のデータだけで「このモデルは良さそうか」を確認するオフライン検証を挟む。
- オフラインでは、NDCGやMRRといった「並び順の良さ」を測る指標や、正解率・適合率などの分類指標を使う
- オフラインの指標とA/Bテストの結果がどれくらい一致するかを継続的に記録している
- ただし完全には一致しないので、オフラインの結果は「本番投入の最終判断」ではなく「次のA/Bテストに進む価値があるか」の判断材料として使う
つまり「オフラインで筋が良さそうと分かったものだけを、実際のA/Bテストにかける」という2段構えの検証プロセスになっている。
「映画ソムリエ」にどう活かすか
さて、以上を踏まえて、自作アプリを改善できるか考察する。
「映画ソムリエ」は、ペア比較(勝ち負け)でElo風のレーティングを個人ごとに作り、そのレーティングと好みの特徴(あらすじ・監督・キャストなど)を混ぜてスコアリングする仕組みになっている。
Netflixのレコメンドエンジンと比較して見ると、以下が改善ポイントになるのではないかと思う。
- w1 × 人気度 + w2 × あなた向けの予測点 + 定数の式を使ってみる。
- 最終的なおすすめリストに多様性の仕組みを加えてみて、同じ監督・同じジャンルの作品ばかりが上位を独占するのを防ぐ。
- 重みが全部ハードコードで手動チューニングされているので、Learning to Rankで比較履歴から重みを学習することを実装に組み込む。(ただしユーザー情報を蓄積する必要があるため、要検討)
最後に
映画をお勧めするのってすごい難しいね、、、。