はじめに
画像認識でLatexを書けたらどんなにいいか、僕はそう考えていた。
実際に、Mathpixというサービスでは画面上の数式のスクショを撮り、その数式からLatexを求めることができる。

また、kaggleには「IM2LATEX-230k」という、Latexの画像認識用のデータがあるため、これを使用して画像認識のモデルを構築しようと考えていた。

しかし、画像認識モデルは上手くいかなかった。
1週間ぐらいかけたものの、精度が壊滅的だったのだ。
しかも、GPUを買うお金もないので、学習はCPU頼りという、かなり頼りない環境だった。
そこで思ったのはGemmaで良くないか?ということだ。
ということで今回はそもそもGemmaでLatexの画像認識が有用かどうかを検証した。
環境設定
環境はwsl上で行う。
各コマンドを実行していく。
ollamaのinstall
sudo apt-get install -y zstd
curl -fsSL https://ollama.com/install.sh | sh
サービス起動確認
systemctl is-active ollama
curl -s http://localhost:11434
モデルをpull
ollama pull gemma3:4b
ollama pull gemma4:e2b
画像認識の実行
source .venv/bin/activate
python3 ollama_gemma_latex.py 画像パス
上記のpullのところでもあるように、今回はgemmaの3と4の2つを用いて比較も行う。
実行したコード
コードは以下のようになっている。
import base64
import sys
import requests

OLLAMA_URL = "http://localhost:11434/api/generate"
MODEL = "gemma4:e2b"
PROMPT = "この画像に写っている数式・LaTeX表現を読み取り、LaTeXコードとして書き起こしてください。"


def recognize(image_path: str) -> str:
    with open(image_path, "rb") as f:
        image_b64 = base64.b64encode(f.read()).decode("utf-8")

    resp = requests.post(
        OLLAMA_URL,
        json={
            "model": MODEL,
            "prompt": PROMPT,
            "images": [image_b64],
            "stream": False,
        },
        timeout=600,
    )
    resp.raise_for_status()
    return resp.json()["response"]


if __name__ == "__main__":
    paths = sys.argv[1:]
    if not paths:
        print("usage: python ollama_vision_test.py <image1> [image2 ...]")
        sys.exit(1)

    for path in paths:
        print(f"=== {path} ===")
        print(recognize(path))
        print()
WSL上のOllamaに対して、質問を投げかけて画像認識をさせようとするプロンプトが書かれた、とてもシンプルなコードだ。
LaTeX認識結果
5枚の画像で画像認識を実施。
各結果は以下のようになった。
まず、処理時間目安に関して、
- gemma3:4b 約15秒/枚
- gemma4:e2b 約57秒/枚
となっている。いずれもCPUのみ。
1枚目
1枚目の画像(7d4d11a1b7.png)は以下である。
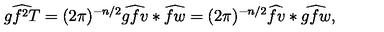
Latexの正解となる表記は以下となる。
\widehat{ g f^2 T } = (2\pi)^{-n/2} \widehat{ g f v } * \widehat{ f w } = (2\pi)^{-n/2} \widehat{ f v } * \widehat{ g f w }
gemma3:4bの出力は以下のようになった。
g f^2 T = (2\pi)^{-n/2} g f v \bar{f} w = (2\pi)^{-n/2} f v g f w
gemma4:e2bの出力は以下のようになった。
g f^2 T = (2\pi)^{-n/2} g f v * f w = (2\pi)^{-n/2} f v * g f w
2枚目
2枚目の画像(51a737c3dd.png)は以下である。
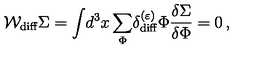
Latexの正解となる表記は以下になる。
{\cal W}{\mathrm{diff}} \Sigma = \int d^3x \sum{\Phi} \delta_{\mathrm{diff}}^{(\varepsilon)} \Phi \frac{\delta \Sigma}{\delta \Phi} = 0
gemma3:4bの出力は以下のようになった。
\mathcal{W}{diff}\Sigma = \int d^3x \sum{\Phi} \delta_{diff}^{(s)}(\Phi) \frac{\delta \Sigma}{\delta \Phi} = 0
gemma4:e2bの出力は以下のようになった。
W_{\text{diff}}\Sigma = \int d^3x \sum_{\phi} \delta^{\prime}(\epsilon) \frac{\delta\Sigma}{\delta\phi} = 0
3枚目
3枚目の画像(1eaeab3e6b.png)は以下である。
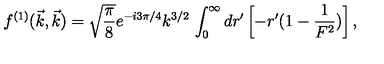
Latexの正解となる表記は以下になる。
f^{(1)}(\vec{k}, \vec{k}) = \sqrt{\frac{\pi}{8}} e^{-i 3\pi/4} k^{3/2} \int_{0}^{\infty} dr' \left[ -r'(1 - \frac{1}{F^2}) \right]
gemma3:4bの出力は以下のようになった。
f^{(1)}(\vec{k}, k) = \sqrt{\frac{\pi}{8}} e^{-i\frac{3\pi}{4}k^{3/2}} \int_{0}^{\infty} d r' \left[ -r' \left( 1 - \frac{1}{F^2} \right) \right]
gemma4:e2bの出力は以下のようになった。
f^{(1)}(\vec{k}, \vec{k}) = \sqrt{\frac{\pi}{8}} e^{-i 3\pi/4 k^3/2} \int_{0}^{\infty} dr' \left[ -r'(1 - \frac{1}{F_2}) \right]
4枚目
4枚目の画像(1887bc41cf.png)は以下である。
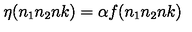
Latexの正解となる表記は以下になる。
\eta(n_1 n_2 n k) = \alpha f(n_1 n_2 n k)
gemma3:4b
\eta(n_1 n_2 n_k) = \alpha f(n_1 n_2 n_k)
gemma4:e2b
\eta(n_1 n_2 nk) = \alpha f(n_1 n_2 nk)
5枚
5枚目の画像(5afbdd6bbe.png)は以下である。
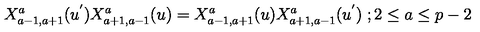
Latexの正解となる表記は以下になる。
X_{a-1,a+1}^{a}(u') X_{a+1,a-1}^{a}(u) = X_{a-1,a+1}^{a}(u) X_{a+1,a-1}^{a}(u') ; 2 \le a \le p-2
gemma3:4b
X^{a-1,a+1}(u') X^{a+1,a-1}(u) = X^{a-1,a+1}(u') X^{a+1,a-1}(u); \quad 2 \leq a \leq p - 2
gemma4:e2b
X_{a}^{a-1, a+1}(u) X_{a+1, a-1}(u) = X_{a}^{a-1}(u) X_{a+1, a-1}(u') ; 2 \le a \le p-2
最後に
惜しくはあるものの、全滅だった。
ただ、無料でここまで認識できるgemmaの機能の高さを知れた。
あと、gemma3:4bからgemma4:e2bにしたところであまり改善されないというところも収穫だったと思う。
当然だとは思うが式が長くなればなるほど認識がうまくいっていないように見える。
ファインチューニングを学んで実践すれば、あと一歩なのかもしれない。