統計検定を受けるにあたって、勉強したことをアウトプットとして残していこうと思う。
コーヒーショップの例を使う。
確率変数
確率によって値が決まる変数を確率変数という。
たとえば、
- $X =$「ある1時間に来店する客数」
- $Y =$「1人の客の購入金額(円)」
- $Z =$「1日に売れるカフェラテの杯数」
などが確率変数である。
離散型と連続型
確率変数には大きく2種類あって、
- 離散型確率変数
- 連続型確率変数
である。
離散型確率変数は飛び飛びの値をとるものである。
例えば以下のようなものだ。
- 1時間の来店客数: 0人, 1人, 2人, 3人, …
- フードを買った個数: 0個, 1個, 2個, …
連続型確率変数は区間の中でなめらかに値をとるものである。
例えば以下のようなものになる。
- 1杯の提供時間(分)
- 客の滞在時間(分)
- 購入金額のうち重さ売り商品の量
確率関数
離散型確率変数 $X$ が値 $x$ をとる確率
$$ P(X = x) $$
を与える関数を確率関数(PMF: probability mass function)という。
例1:
$X =$「午後3時台の来店客数」とする。あるデータ分析から、
$$P(X=0)=0.10,\quad P(X=1)=0.20,\quad P(X=2)=0.40,\quad P(X=3)=0.20,\quad P(X=4)=0.10$$
という値になったとする。
このとき、
- 2人来店する確率は $0.40$
- 3人以上来店する確率は $0.20 + 0.10 = 0.30$
となる。
確率関数では、全てを足すと1になる(つまり、$\sum_x P(X=x)=1$)
期待値
確率変数の「平均的な大きさ」を表すのが期待値である。
離散型では
$$E[X] = \sum_x xP(X=x)$$
で定義される。
例2:
先ほどの例1の来店客数 $X$ について期待値を求めると、
$$E[X] = 0 \times 0.10 + 1 \times 0.20 + 2 \times 0.40 + 3 \times 0.20 + 4 \times 0.10$$
$$= 0 + 0.20 + 0.80 + 0.60 + 0.40 = 2.00$$
したがって、**平均すると午後3時台には2人来店する**と解釈できる。
$E[X^2]$ は$x$ を $x^2$ に変えるだけ
$E[X^2]$ は$x$ を $x^2$ に変えるだけである。
$$E[X^2] = \sum_x x^2 P(X=x)$$
期待値 $E[X]$ が「値 $x$ の確率つき平均」なのに対して、$E[X^2]$ は「値の二乗 $x^2$ の確率つき平均」となる。
たとえば、午後3時台の来店客数 $X$ について
$$P(X=0)=0.10,\quad P(X=1)=0.20,\quad P(X=2)=0.40,\quad P(X=3)=0.20,\quad P(X=4)=0.10$$
なら、
$$E[X^2] = \sum_x x^2 P(X=x)$$
$$= 0^2 \times 0.10 + 1^2 \times 0.20 + 2^2 \times 0.40 + 3^2 \times 0.20 + 4^2 \times 0.10$$
$$= 5.20$$
この $E[X^2]$ は、そのまま分散
$$\mathrm{Var}(X)=E[X^2]-(E[X])^2$$
を計算するときに使われる。
期待値の見方
期待値は何度も同じ状況をくり返したときの長い目で見た平均である。
たとえば、実際の1時間の来店客数は 0人、1人、2人、3人などにばらつく。
しかし、長期間観測すると平均が2人くらいに近づく、というのが期待値の意味である。
分散
平均だけでは、ばらつきの大きさはわからない。
そこで使うのが分散である。
分散は
$$\mathrm{Var}(X) = E[(X – E[X])^2]$$
で定義される。
この定義は、ほぼ定義として覚えておくべき式であるが、 丸暗記するより以下を抑えておくと忘れにくい。
- $X – E[X]$ は「平均からのずれ」
- それを二乗した $(X-E[X])^2$ は「ずれの大きさ」
- それを平均した $E[(X-E[X])^2]$ は「平均的にどれくらい散らばっているか」
つまり、分散は平均からのずれの二乗平均であると言える。
分散は以下の表記でも使用することがある。
$$ \mathrm{Var}(X) = E[X^2] – (E[X])^2 $$
例3:
先ほどの例1の $X$ について、まず $E[X^2]$ を求める。
$$ E[X^2] = 0^2 \times 0.10 + 1^2 \times 0.20 + 2^2 \times 0.40 + 3^2 \times 0.20 + 4^2 \times 0.10 $$
$$ = 0 + 0.20 + 1.60 + 1.80 + 1.60 = 5.20 $$
したがって、
$$ \mathrm{Var}(X) = 5.20 – 2.00^2 = 5.20 – 4.00 = 1.20 $$
となる。
分散が大きいほど、来店客数のぶれが大きい。
標準偏差
分散は便利だが、単位が二乗になってしまう。
そこで、分散の平方根をとった標準偏差がよく使われる。
$$ \sigma = \sqrt{\mathrm{Var}(X)} $$
上の例では
$$ \sqrt{1.20} \approx 1.095 $$
である。
これは「来店客数は平均2人のまわりに、だいたい1人前後のぶれを持つ」と読む助けになる。
確率密度関数
連続型確率変数では、ある1点ちょうどをとる確率は基本的に $0$ と考える。
その代わり、どのあたりに値が集まりやすいかを表す関数を使う。これが確率密度関数である。
連続型確率変数 $X$ の確率密度関数を $f(x)$ とすると、
$$ P(a \le X \le b) = \int_a^b f(x)\,dx $$
で区間の確率を求める。
例4:
$X =$「ドリンク提供時間(分)」とする。
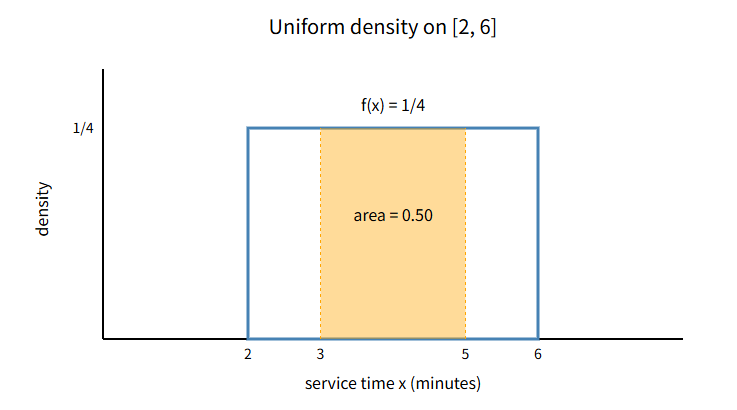
もし提供時間が 2分から6分の間で一様にばらつくなら、密度関数は
まず、「一様にばらつく」とは、2分から6分のどこでも同じ高さの密度になるという意味である。
そこで、この区間では高さが一定の長方形になると考え、
$$ f(x)=c \quad (2 \le x \le 6) $$
とおく。ここで $c$ はまだわからない定数である。
確率密度関数は、グラフ全体の面積が1になるように決めなければならない。
この例では、底辺の長さは
$$ 6-2=4 $$
なので、長方形の面積は
$$ 4 \times c $$
である。これが $1$ になればよいから、
$$ 4c=1 $$
$$ c=\frac{1}{4} $$
となる。したがって、密度関数は
$$ f(x) = \frac{1}{4} \quad (2 \le x \le 6) $$
で、それ以外では $0$ である。
つまり、この $\frac{1}{4}$ は**「底辺が4なので、面積を1にするには高さを $\frac{1}{4}$ にする必要がある」**ことから決まっている。
このとき、提供時間が3分から5分の間である確率は
$$ P(3 \le X \le 5) = \int_3^5 \frac{1}{4}\,dx = \frac{2}{4} = 0.50 $$
となる。
ここでも、面積で考えるとわかりやすい。
区間 $[3,5]$ の幅は
$$ 5-3=2 $$
なので、その部分の面積は
$$ 2 \times \frac{1}{4} = \frac{1}{2} $$
となり、確率 $0.50$ が得られる。